红领巾宣讲视频:从活动通知到成片
六段手机素材(分辨率不一,其中一段还是竖屏)做成 1 分 57 秒横屏宣讲片:按活动通知写稿定镜头、按旁白重排素材、把竖屏素材裁成 16:9 而不拉伸、逐句烧录中文字幕,并从人声底下抽出陵园外的车流噪声。
成片
1:57 · 1280×720 · 22 MB · 含字幕、配乐、片头幕与结尾幕
降噪前后试听
20 秒交替播放:人声、人声、环境音、环境音 —— 原文、处理后、原文、处理后
素材里的三处坑
任务
学校少先队活动要求交一个两分钟以内的横屏宣讲视频——由一名三年级学生讲述一处红色地标。通知给出的是约束,小荷把它变成方案:两分钟约等于 305 个汉字的容量,于是先把旁白按这个长度预算写出来,再拆成五个镜头,每镜附纪念碑、烈士墓、血祭轩辕亭的画面设计与拍摄要点,拿到实地去拍。
实际拿回的是六段素材,方案在这里经受检验:好的一遍过镜头对得上对应的镜位;其余则按旁白逻辑而非拍摄顺序重排,或裁掉冗长镜头,让成片落进时长上限。
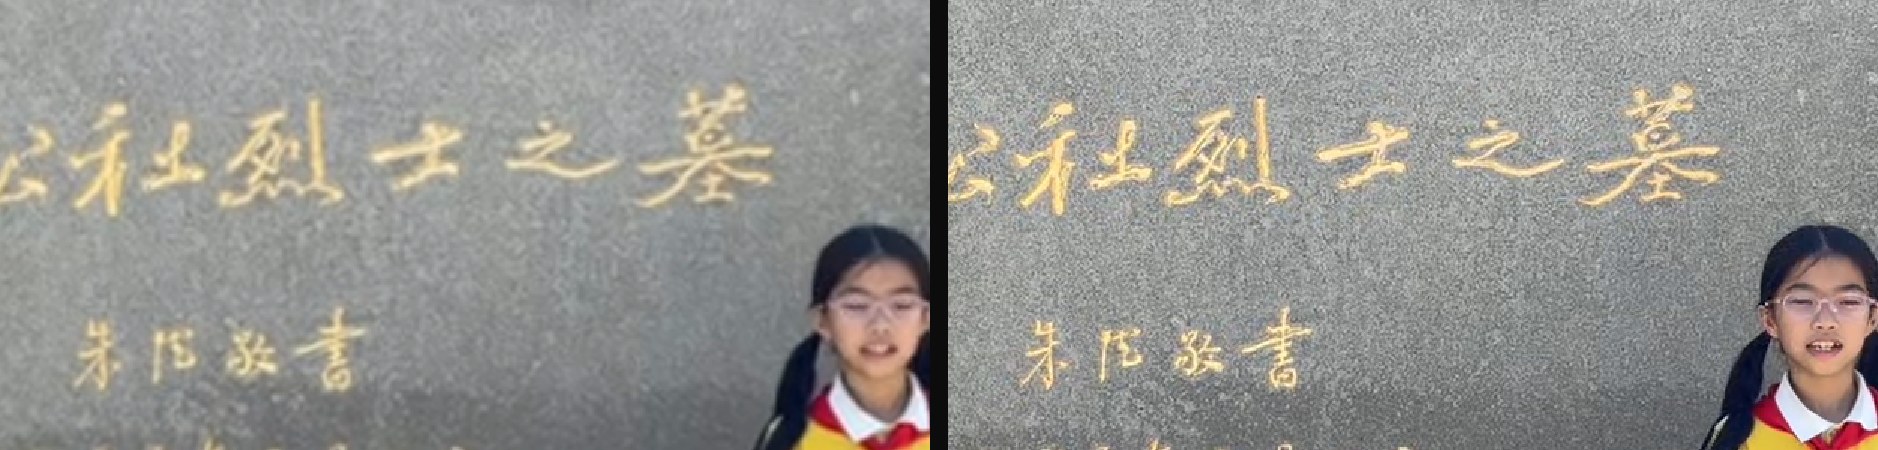
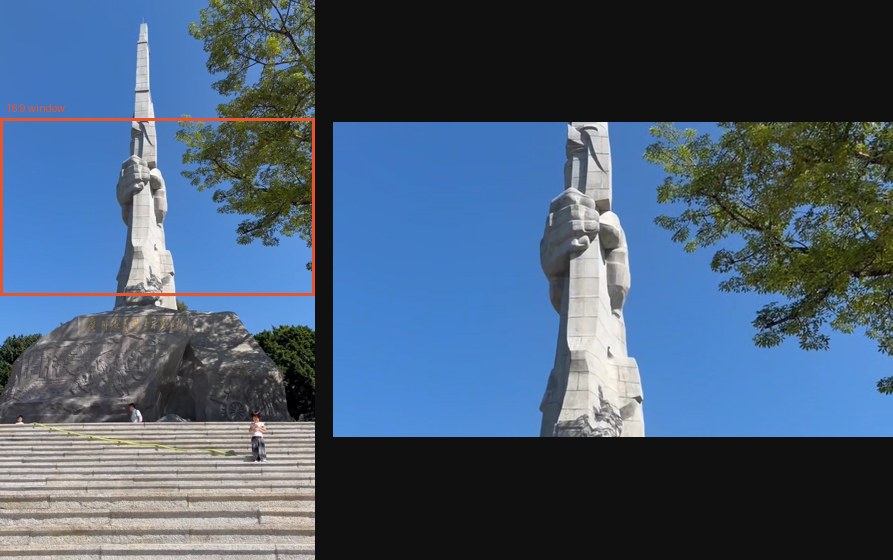
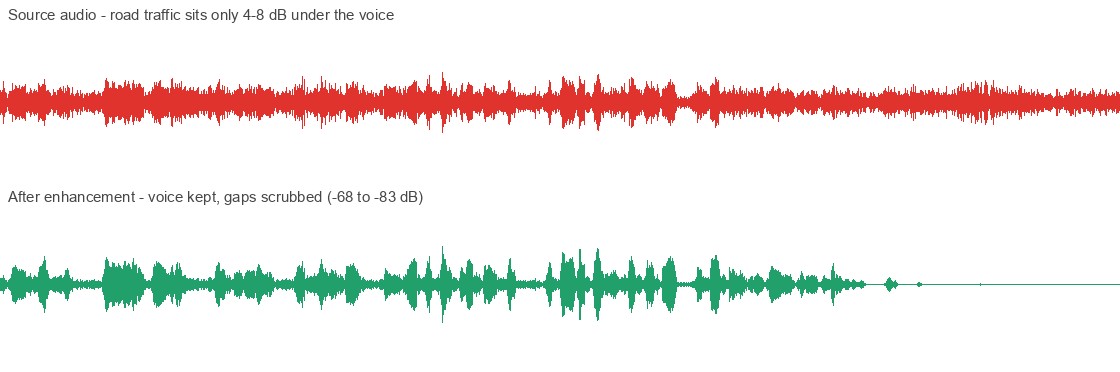
有三处会让「直接剪一剪」翻车。素材是 568×320——已被聊天软件压过一道——所以输出 720p 大半是凭空插出来的细节。有一段是竖屏,存成横屏文件只带旋转标记;硬塞进 16:9 会把整个画面压扁。陵园紧邻一条主干道:实测车流噪声只比人声低 4–8 dB,所以「降噪一下」不是一行命令能解决的。
小荷把方案与素材的差异一一对齐。好的一遍过镜头对得上镜位就留;其余按旁白逻辑重排。竖屏那段裁一个跟随镜头上摇、缓动上移的 16:9 取景窗,让纪念碑落定在天空背景上,而不是留三分之二画面给模糊填充。字幕逐句渲染成透明图层再合成,因为本机 ffmpeg 没有 libass;车流噪声交给语音增强模型。后来用户找回了更清晰的素材,整片又在新素材上重剪了一遍。
有两处不是技术判断。用户提出「按孩子的音色重新生成旁白」,小荷没有做,并说明了原因:授权通道没有声音克隆;视频里她正面出镜讲话,换成合成音轨会破坏口型;而这项作业本身就是她本人宣讲,不该替。稿子里的事实——题字出自谁手、几个日期与数字、亭子的名字——也逐条对着公开资料核过,并把核对表留给家长查验。成片 22 MB,此前码率未与素材实际信息量匹配时是 38 MB。
小荷怎么做
1. 把通知写成稿子
通知里「限时两分钟」是硬约束,于是折算成长度预算:约 305 字、五个镜头,每镜附画面与拍摄提示。
2. 取素材
活动通知是微信里的 PDF;六段素材在文件夹里,文件名是无意义的 hash。两者都归入孩子的学校文件夹并改成可读命名。
3. 逐段摸清底细
探测发现分辨率与帧率都不统一,且有一段带 rotation=-90——一个藏在横屏容器里的竖屏视频。
ffprobe -show_entries stream=width,height,side_data_list
4. 测出人声的确切区间
对每段做逐帧能量分析,配合词级时间戳。第一版凭经验把语音区间起点定在 1.0 秒,而她的第一个词在 0.00 秒——结果开头一秒的旁白被重抑制压掉;修正办法是改用实测边界。
whisper --word_timestamps True
5. 救回竖屏素材
不用模糊补边,而是裁一个 16:9 取景窗,跟着镜头上摇缓动上移,让「巨手紧握步枪」那组雕塑落进天空背景。
crop=w=720:h=405:y='875-605*(1-cos(PI*min(1\,t/7.0)))/2'
6. 在没有 libass 的情况下烧字幕
本机 ffmpeg 没有 libass 也没有 freetype。于是每句用 Pillow 渲染成透明 PNG,各自在自己的时间窗内叠加——顺带做到了帧级精确,此前用 concat 解复用器拼字幕轨会漂移约一秒。
overlay=0:0:enable='between(t,3.20,7.20)'
7. 把噪声从人声底下抽出来
四条路线都是量化比较而非凭感觉:ffmpeg 谱减、noisereduce、DeepFilterNet、MossFormer2,用同一段素材的人声/间隙比打分。DeepFilterNet 胜出,随后才是关键——它的抑制上限一直没设,所以连人声一起压。语音段设上限、间隙段不设,信噪比从素材的 8.4 dB 提到 40.5 dB,而人声只被压 4.1 dB。
enhance(model, df_state, audio, atten_lim_db=12)
8. 让码率匹配素材的信息量
第一版把大部分码率花在「放大算法造出来的细节」上。用 SSIM 对照的一条 CRF 阶梯选出了「体积降 63% 而看不出差别」的位置——在软素材上是 38 MB 降到 14 MB;换成真正更清晰的原片后是 22 MB。
9. 交付并附上核对表
脚本随附一张事实核对表,逐条给出公开出处,让家长可以自己核对而不是照单全收。
用到的技能
- mywechat
- ffmpeg
- Whisper · 词级时间戳
- DeepFilterNet
- Pillow · 字幕渲染
- mytoolkit · convert
交付产物
更多作品
真实任务,从终端到一份成品文档。